


🧭 TL;DR: di cosa parliamo in questo numero
Parliamo della questione del momento nel mondo dell’IA (e non solo): una partita che sembra tecnica ma è anche economica e geopolitica. Se volete capire davvero la discussione globale in corso, questo numero fa per voi.
Vi spieghiamo - con una storia che comincia nel 1991 - la differenza tra IA chiusa e IA aperta (e perché “open source” non sempre significa quello che credete). Cosa cambia per utenti, professionisti e pubbliche amministrazioni.
In questo modo, descriviamo la AI race, la sfida tra i due protagonisti della corsa all’IA: gli USA che puntano sui modelli proprietari vs. la Cina che diffonde gratis nel mondo i suoi modelli aperti. Washington valuta restrizioni all’open source, mentre 50 aziende - con il primo storico post su X di Jensen Huang - firmano un appello per evitare quello scenario.
Come nelle migliori storie, non tutto è come sembra: qui i buoni e i cattivi non si riconoscono al primo sguardo. Non fatevi ingannare dalle apparenze.
🧑💻 Tutto inizia a Helsinki
25 agosto 1991, trentacinque anni fa. Uno studente finlandese di 21 anni, occhiali spessi e nessuna particolare propensione al marketing, pubblica su un forum di appassionati (ve li ricordate i forum?) un messaggio destinato a entrare nella storia, soprattutto per la sua disarmante modestia:
Sto facendo un sistema operativo (gratuito): è solo un hobby, niente di grande e professionale.
Lo studente si chiama Linus Torvalds. Il suo “hobby” si chiamerà Linux e diventerà uno dei sistemi operativi più importanti al mondo. Ma, invece di venderlo, di brevettarlo, di custodirlo, Linus lo regala. Pubblica il codice e chiede al mondo una sola cosa: se trovate errori, ditemelo.
È un momento cruciale per lo sviluppo di quello che oggi chiamiamo open source (anche se il termine arriverà solo qualche anno dopo): software il cui codice è pubblico, e che chiunque può, a sua volta, studiare, modificare, migliorare e ridistribuire liberamente.
Trentacinque anni dopo, quell’hobby fa girare la maggior parte dei server di internet, è alla base di tutti i telefoni Android, i supercomputer e persino alcuni sistemi del Pentagono. Non male, per qualcosa di “non grande e professionale”.
Dalla storia di Linus, anni dopo, il programmatore e saggista Eric Raymond ricavò una “legge” battezzata in suo onore, la legge di Linus:
Dato un numero sufficiente di occhi, tutti i bug vengono a galla.
Tradotto: un software che tutti possono leggere e correggere diventa, col tempo, più robusto di uno coperto da segreto, perché ogni difetto - per quanto nascosto - prima o poi incontra l’occhio giusto. Insomma, la conoscenza condivisa batte il segreto.
Naturalmente non tutti, all’inizio, la pensavano come Linus. Anzi: quasi nessuno. L’industria del software era costruita sul principio opposto (quello dei software “proprietari” di cui si compra solo la licenza d’uso): il codice è un segreto industriale, si vende il prodotto e si custodisce la formula (come con la Coca Cola). Ai vertici di quel mondo, l’open source sembrava un’idea tra l’ingenuo e il sovversivo; addirittura, nel 2001 il CEO di Microsoft, Steve Ballmer, arrivò a definire Linux “un cancro” che si attacca a tutto ciò che tocca.
Da allora, questi due modi di intendere il software convivono. E per capire la differenza proviamo a pensare a due diversi modi di mangiare fuori.
Il software proprietario è un ristorante tradizionale. Entrate, ordinate, pagate, mangiate (anche benissimo). Ma la cucina è off limits: non sapete cosa c’è nelle pentole, non potete chiedere variazioni fuori menu e, soprattutto, il ristoratore può in ogni momento alzare i prezzi, cambiare i piatti o decidere di non farvi più entrare. Se il ristorante chiude, restate a digiuno. Windows, Office, iOS sono alcuni esempi dei più importanti software proprietari.
Il software open source, invece, è un ristorante che, insieme al piatto, vi consegna la ricetta. Potete mangiare lì, comodamente, come in qualunque altro locale, ma potete anche portarvi la ricetta a casa, rifare il piatto quando volete, con le variazioni che volete (più peperoncino, meno sale), e passarla ai vicini, magari migliorata. Se un giorno il ristorante alza i prezzi, cambia menu o chiude, poco male: la ricetta ormai è vostra. Nessuno può presentarvi un conto a sorpresa e, soprattutto, nessuno può più togliervela: nemmeno il cuoco che l’ha inventata. E se pensate che sia roba da programmatori, guardatevi in tasca o sulla scrivania: l’open source lo usate già, tutti i giorni. Basti pensare ad Android, al browser Firefox o a Wordpress (su cui gira oltre il 40% dei siti web del mondo).
Due precisazioni, prima di andare avanti:
Aperto non vuol dire gratis, né anticommerciale. Come ripete Richard Stallman, il profeta del software libero, “free” come in “free speech”, non come in “free beer”. Sulla ricetta condivisa si possono costruire (e si costruiscono) business miliardari.
Software proprietario non vuol dire cattivo (il ristorante garantisce controllo, qualità costante, qualcuno che risponde se qualcosa va storto). Sono due filosofie, ciascuna con i suoi pregi.
Linus - lo studente che regala il suo hobby al mondo e in cambio chiede solo di segnalargli gli errori - sembra evidentemente il classico eroe buono delle favole, chi bolla la condivisione come "un cancro" si candida da solo alla parte del cattivo.
Siamo cresciuti imparando a riconoscere i cattivi al primo sguardo (al cinema) oppure alle prime parole di descrizione dei personaggi (nella letteratura). Darth Vader ha il respiro meccanico e la marcia imperiale che lo annuncia, Voldemort non ha il naso, Sauron è - letteralmente - un gigantesco occhio cattivo. E poi Capitan Uncino, il lupo di Cappuccetto Rosso, il professor Moriarty: il cattivo si riconosce subito, così come l’eroe.
Ma nella realtà è raramente così facile distinguerli. E non tutto è come sembra.
🇺🇸 OpenAI o ClosedAI?
Per decenni, comunque, le due filosofie (software proprietario e open source) hanno convissuto senza troppi drammi. Poi è arrivata la corsa allo sviluppo dell'intelligenza artificiale e la tensione “open vs. closed” ha acquisito un nuovo significato.
Già alla fine del 2015, in Silicon Valley l’intelligenza artificiale più avanzata stava diventando affare di un solo operatore. Google aveva comprato DeepMind, il laboratorio più promettente del mondo. Un gruppo di imprenditori e ricercatori - tra cui Elon Musk e Sam Altman - decide che no, non può finire così: il futuro dell’umanità non può essere il segreto industriale di un’azienda.
E allora fondano un laboratorio non profit, con una dichiarazione d’intenti che sembrava scritta da Linus Torvalds: l’obiettivo era far progredire l’intelligenza artificiale “nel modo più utile all’umanità nel suo complesso, senza il vincolo di generare profitti”. E i ricercatori erano fortemente motivati a pubblicare tutto: articoli, codice, metodologie di addestramento.
Il nome che scelgono per la nuova organizzazione dice tutto. OpenAI: intelligenza artificiale aperta. La legge di Linus applicata all’intelligenza artificiale non è soltanto in una licenza, ma è - letteralmente - la ragione sociale.
I lettori di lunga data di questa newsletter sanno già come è andata a finire (l'abbiamo raccontato nella nostra serie sui processi tra Musk e OpenAI).

Nei primi anni, la promessa di OpenAI viene mantenuta: ricerche pubblicate, codice condiviso, modelli documentati, fino a GPT-2, rilasciato nel 2019. È l'ultima volta. Da lì in poi, in corrispondenza di investimenti sempre più miliardari - il patto con Microsoft su tutti - il rubinetto si chiude: il laboratorio non profit si trasforma in una società a scopo di lucro e i modelli successivi escono solo in licenza d’uso e con sempre meno informazioni (né dati di addestramento, né architettura, né dimensioni).
E non è un caso isolato: lo standard USA di sviluppo e distribuzione dell’IA è di tipo proprietario. Anthropic, Google, la stessa OpenAI: i modelli di frontiera - i più potenti del pianeta - sono chiusi, si usano tramite abbonamenti e API, e le loro capacità sono concentrate nelle mani di pochissimi laboratori, tutti nel raggio di pochi chilometri l'uno dall'altro, con poche informazioni sull’addestramento, sulla sicurezza e sulle logiche di funzionamento dei modelli.
Certo, ogni tanto anche i grandi laboratori proprietari pubblicano modelli aperti: Google rilascia la famiglia Gemma, e perfino OpenAI nel 2025 ha rilasciato Gpt-oss, il suo primo modello a pesi aperti dai tempi di GPT-2. Ma sono eccezioni che confermano la regola: modelli più piccoli e meno capaci di quelli di punta. I migliori, quelli di frontiera, restano chiusi.
🔍 Cosa vuol dire (davvero) “IA open source”
Prima di proseguire, però, dobbiamo intenderci sulle parole. Perché nell’intelligenza artificiale l’apertura si misura su una scala.
Sul gradino più basso ci sono i modelli chiusi (quelli che tutti conoscete come ChatGPT, Claude, Gemini): si usano tramite app o API e di quello che c’è dentro non si sa quasi nulla.
Sul gradino intermedio, ci sono i modelli open weight, “a pesi aperti”. I pesi sono le innumerevoli regolazioni interne che il modello sviluppa durante l’addestramento. Un po’ come miliardi di manopole, determinano quali collegamenti il sistema fa tra parole, concetti e informazioni e, quindi, il modo in cui risponde alle domande. Renderli pubblici significa che chiunque può scaricare il modello, installarlo sui propri computer, modificarlo e adattarlo ai propri scopi. Restano però segreti i dati utilizzati per addestrarlo e, spesso, anche molti dettagli sul procedimento seguito.
Sul gradino più alto della scala c’è l’open source vero e proprio: pesi, codice e dati di addestramento sono pubblicamente accessibili, insieme alle informazioni necessarie per comprendere come il modello è stato costruito. È ancora una rarità. Tra i pochi esempi c’è Minerva, la famiglia di modelli sviluppata dalla Sapienza Università di Roma, addestrata da zero con una particolare attenzione alla lingua italiana e utilizzando fonti aperte e documentate.
Cosa cambia, in concreto, rispetto ai modelli commerciali? Per un utente privato, un modello aperto è un modello che può girare sul proprio computer: si installa (provate con strumenti gratuiti come Ollama o LM Studio, se non sapete programmare), funziona anche senza connessione, non manda i vostri dati a nessun server e nessuna azienda può ritirarlo, rincararlo o spegnerlo. Per fare una prova, scaricate un modello, staccate il wi-fi, e continuerà a rispondervi.
Per un professionista, un’azienda o una pubblica amministrazione, la differenza è prima di tutto una questione di controllo, contratti e compliance. Quando si utilizza un modello chiuso attraverso il servizio del produttore (pensate a ChatGPT), i dati vengono normalmente trasmessi ai suoi server e trattati alle condizioni stabilite nel contratto. Un modello aperto, invece, può essere installato sui propri server o su un’infrastruttura controllata dall’organizzazione (e, in questo caso, prompt e documenti non escono dal perimetro informatico dell’organizzazione stessa). È questa possibilità a consentire a uno studio legale, a un ospedale o a una pubblica amministrazione di usare l’IA anche su documenti che non potrebbe, o non vorrebbe, affidare al cloud di un fornitore. L’apertura riduce inoltre la dipendenza dal provider, permette di adattare il modello alle proprie esigenze e offre un maggiore controllo sui costi e sul funzionamento del sistema.
E poi c’è la trasparenza. La disponibilità dei pesi e dei dati di addestramento consente a tutti di eseguire il modello, sottoporlo a test, confrontarne i comportamenti e cercare vulnerabilità e distorsioni: una versione della legge di Linus applicata all’IA, secondo cui molti osservatori possono rendere più facile individuare i difetti.
🇨🇳 La scommessa cinese
Proprio quando tutti pensavano che il modello vincente dell’IA sarebbe stato quello chiuso statunitense, della “più grande democrazia del mondo” - in cui pochi provider mettono a disposizione di centinaia di milioni di utenti nel mondo i propri modelli di IA in una logica proprietaria - la Cina sceglieva di scommettere sull’open source. E lo faceva in grande stile.
Il momento in cui ce ne siamo accorti è stato nel gennaio 2025, quando DeepSeek - un laboratorio di Hangzhou fino ad allora sconosciuto ai più - pubblica R1, un modello a pesi aperti che eguaglia i migliori modelli chiusi americani nei test di ragionamento, addestrato (dichiaratamente) a una frazione del loro costo. Il venture capitalist Marc Andreessen lo definisce il “momento Sputnik” dell’IA, l’app di DeepSeek scalza ChatGPT dalla vetta dell’App Store e Wall Street brucia centinaia di miliardi di capitalizzazione in un giorno.
Da allora è stata un’ondata: la famiglia Qwen di Alibaba, GLM di Zhipu AI (sì, il modello che ha soccorso Hugging Face come abbiamo raccontato nel numero scorso) e Kimi di Moonshot AI, il cui K3 - rilasciato il 16 luglio - è considerato tra i modelli attualmente più capaci al mondo. Nei benchmark internazionali i modelli aperti cinesi performano sempre meglio e si stanno avvicinando alle prestazioni dei modelli di frontiera americani (compresi quelli bloccati perché troppo “pericolosi” come Fable 5). Secondo l’AI Index di Stanford, il divario di performance tra i migliori modelli USA e cinesi ormai si è ridotto a pochi punti percentuali.
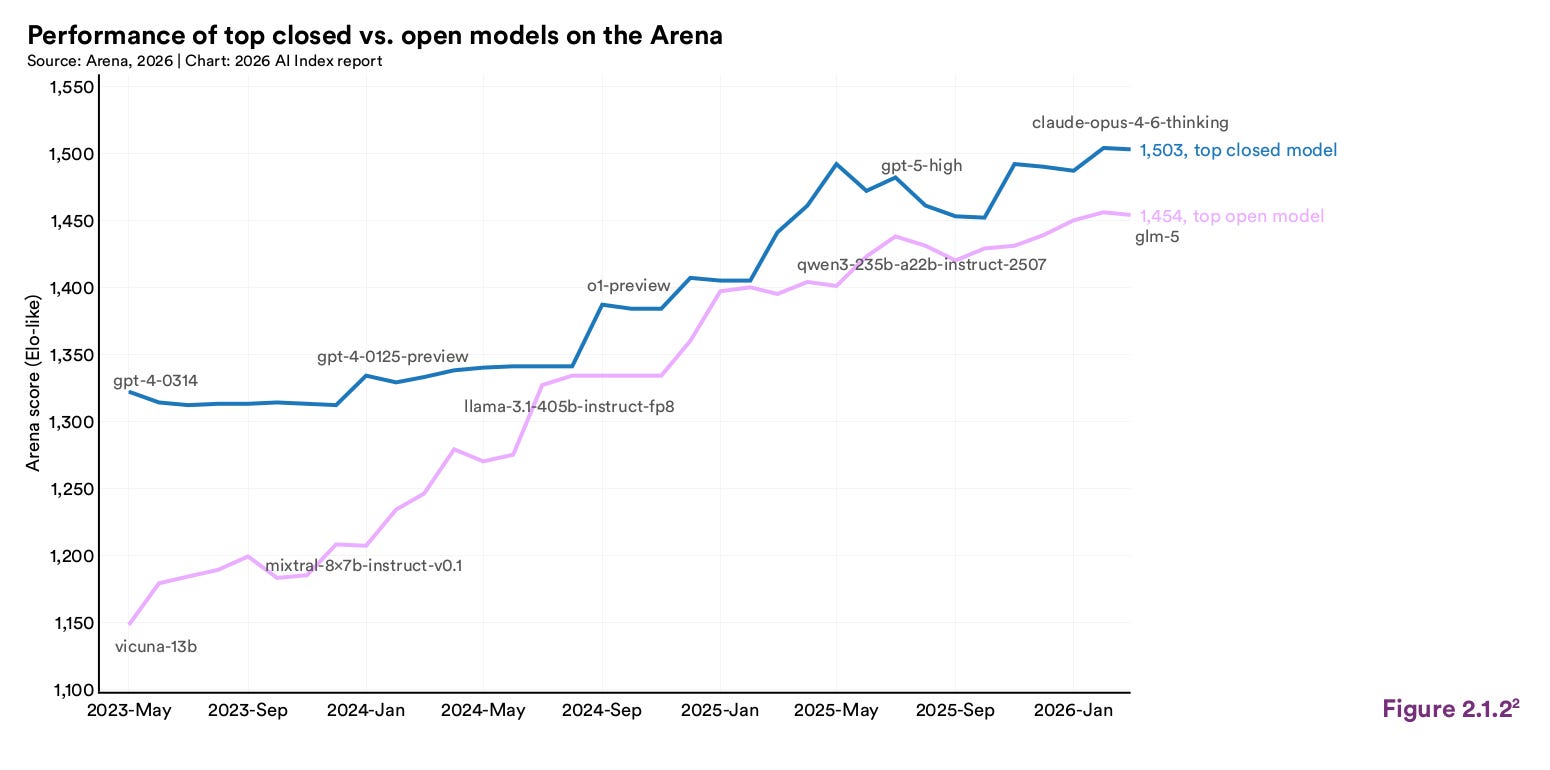
Insomma, i due principali protagonisti della AI Race (la corsa allo sviluppo della superintelligenza artificiale) stanno giocando con due strategie completamente diverse: gli USA vendendo il modello dell’IA proprietaria, la Cina diffondendo nel mondo le proprie IA aperte. E il dato che rende la sfida clamorosa è che le aziende cinesi stanno facendo tutto senza gli investimenti della Silicon Valley. Nel 2025, gli investimenti privati in IA negli Stati Uniti hanno superato di oltre venti volte quelli cinesi e i chip più avanzati in Cina non dovrebbero nemmeno arrivare, per effetto degli export control americani. Così i laboratori cinesi hanno trasformato la scarsità in metodo: modelli più efficienti, costi dichiarati che sono una frazione di quelli americani e distribuzione gratuita a chiunque, ovunque. Almeno per ora.
Perché il punto è proprio questo: non è la scelta di qualche laboratorio, è una strategia nazionale. Pechino ha inserito l’open source nei suoi piani industriali per l’IA e il 17 luglio Xi Jinping in persona, dal palco della World AI Conference di Shanghai, ha usato “apertura” come parola chiave del proprio discorso. Il risultato è che oggi uno studio legale brasiliano, un ministero italiano o una startup nigeriana possono costruire la propria IA su fondamenta cinesi senza pagare un dollaro. E chi costruisce per anni su una tecnologia, difficilmente poi cambia le fondamenta.
Ed è esattamente questo che spaventa Washington.
Così, di fronte a IA cinesi sempre più evolute, nelle istituzioni americane ha preso quota un’idea: introdurre restrizioni ai modelli aperti, a partire da quelli cinesi. Le proposte sul tavolo sono di vario tipo: dal divieto di uso dei modelli sviluppati da Paesi avversari nelle agenzie federali (è l’oggetto del No Adversarial AI Act) al divieto - secondo il disegno di legge più radicale, il Decoupling Act del senatore Hawley - perfino di procedere al semplice download di un modello cinese.
La motivazione dichiarata è la sicurezza. Un modello chiuso, se qualcosa va storto, si può spegnere, aggiornare, limitare. Un modello aperto no. Ma è difficile non vedere anche l’altra faccia della mossa: ostacolare la strategia di Pechino prima che i suoi modelli diventino lo standard mondiale.
✋ C’è chi dice no
In questo contesto, giovedì scorso, Jensen Huang - il CEO di NVIDIA, l’azienda che vende le pale della “corsa all’oro” dell’IA - ha pubblicato un tweet che è diventato immediatamente virale. Huang (con il suo inconfondibile giubbotto di pelle) è una vera e propria rockstar oltre a essere una delle figure più influenti (e ascoltate) della Silicon Valley e a guidare una delle aziende più importanti del mondo (non solo dell’IA). Ha un account X da anni, ma non aveva mai pubblicato nulla. Finché non ha condiviso questo post:
Per il mio primo post, condivido una lettera che NVIDIA ha firmato su perché i modelli aperti sono importanti. L’IA trasformerà ogni industria, alimenterà ogni azienda e sarà costruita da ogni Paese. I modelli aperti rafforzano la sicurezza, accelerano l’innovazione e abilitano la sovranità. Il mondo ha bisogno sia di modelli chiusi di frontiera che di modelli aperti di frontiera.


Quando il vicino silenzioso prende la parola all’assemblea di condominio, tutti capiscono che la questione è seria: fin qui il post ha totalizzato oltre 60 milioni di visualizzazioni.
La lettera - titolo: Open Weights and American AI Leadership (Pesi aperti e leadership americana dell’IA) - è indirizzata ai policymaker statunitensi e comincia esattamente dalla storia dell’open source. L’America - sostengono i firmatari - rischia di rifare con l’IA l’errore che stava per fare col software. Quattro gli argomenti utilizzati: i modelli aperti ampliano l’accesso all’economia dell’IA (startup, università, ospedali), rafforzano la concorrenza, danno ai clienti maggiore controllo e - infine - possono essere più sicuri. La lettera ammette che potrebbero esserci rischi per la sicurezza ma riconosce che la soluzione non è proibirli: se gli attaccanti usano IA avanzata, anche i difensori devono averla.
Le prime firme, giovedì, erano più di venti: tra cui NVIDIA, Meta, Mistral, Hugging Face, Palantir, IBM, Dell, Mozilla, la Linux Foundation (il cerchio si chiude), i grandi fondi come Andreessen Horowitz e Y Combinator. C’era fin dall’inizio anche Microsoft: l'azienda che chiamava l'open source "un cancro" e che oggi firma l'appello per i modelli aperti. In ventiquattr’ore le firme sono raddoppiate, fino a circa 50: si sono aggiunte, dopo che la loro assenza non era passata inosservata, anche Google e OpenAI (mi si nota più se firmo o se non firmo?).
E poi ci sono gli assenti come Amazon e, soprattutto, Anthropic, il laboratorio che da anni si presenta come il provider “etico”, quello che ha portato in tribunale il governo degli USA. Non firma, non commenta, non applaude all’iniziativa, considera i modelli open source come un pericolo.
🎯 Il modello giusto
Nella realtà, dicevamo, i buoni e i cattivi non si riconoscono dal mantello.
La Cina autoritaria può diffondere modelli aperti non necessariamente per amore della libertà o condivisione della conoscenza, ma anche perché l’apertura è uno strumento di potere.
Le aziende dei Paesi democratici possono difendere modelli chiusi non soltanto per profitto, ma anche perché alcuni rischi sono realmente più controllabili.
E chi firma in favore dell’apertura può farlo per ideali, ma anche perché vende chip, server e servizi necessari a far girare quei modelli. Così come chi non firma può farlo per difendere la propria posizione sul mercato oppure perché è convinto che l’apertura porterebbe rischi catastrofici.
La questione, dunque, non è stabilire una volta per tutte se sia migliore l’IA aperta o quella proprietaria. È capire quale grado di apertura sia più adatto alle diverse esigenze. Un cittadino che vuole usare un piccolo modello offline, uno studio legale che deve proteggere documenti riservati, una pubblica amministrazione che vuole evitare il lock-in e un laboratorio che sviluppa un modello di frontiera non hanno necessariamente bisogno della stessa soluzione.
Per questo la distinzione tra modelli chiusi, modelli a pesi aperti e modelli realmente open source non è una disputa terminologica per addetti ai lavori. È una delle chiavi fondamentali per capire ciò che sta accadendo nell’intelligenza artificiale e per scegliere, di volta in volta, chi può accedere ai nostri dati, da quale fornitore vogliamo dipendere, quali rischi siamo disposti ad accettare e quanto controllo vogliamo conservare.
Forse, quindi, Jensen Huang ha ragione: il mondo avrà bisogno sia di modelli chiusi di frontiera sia di modelli aperti di frontiera.
La vera sfida sarà decidere che cosa aprire, che cosa proteggere e, soprattutto, chi avrà il potere - anche normativo - di tracciare quel confine.
😂 IA Meme
Non tutto è come sembra.
🙏 Grazie per averci letto!
Per ora è tutto, arrivederci al prossimo numero.
Se la newsletter ti è piaciuta, sostienici: metti like, commenta o fai girare!